Nature:如何找到顶刊级的论文选题
做科研这些年,我始终觉得,选题可能是整个研究过程中最让人头疼的一步。论文写得不好还可以慢慢修改,数据不会分析也可以继续学习,但如果一开始的问题就没有想清楚,后面读再多文献、收再多数据,都可能是在错误的方向上努力。
现在有了AI以后,找选题看起来变得非常简单。输入一个大方向,让AI生成10个论文题目,几秒钟就能得到一份看起来非常完整的清单。但是,这个是错误的用法!!
AI当然可以快速生成一个“像选题的句子”,但它可能不知道这个方向已经被研究到了什么程度,不知道所谓的研究空白是不是真的存在。通用AI生成生成的题目没有文献依据。
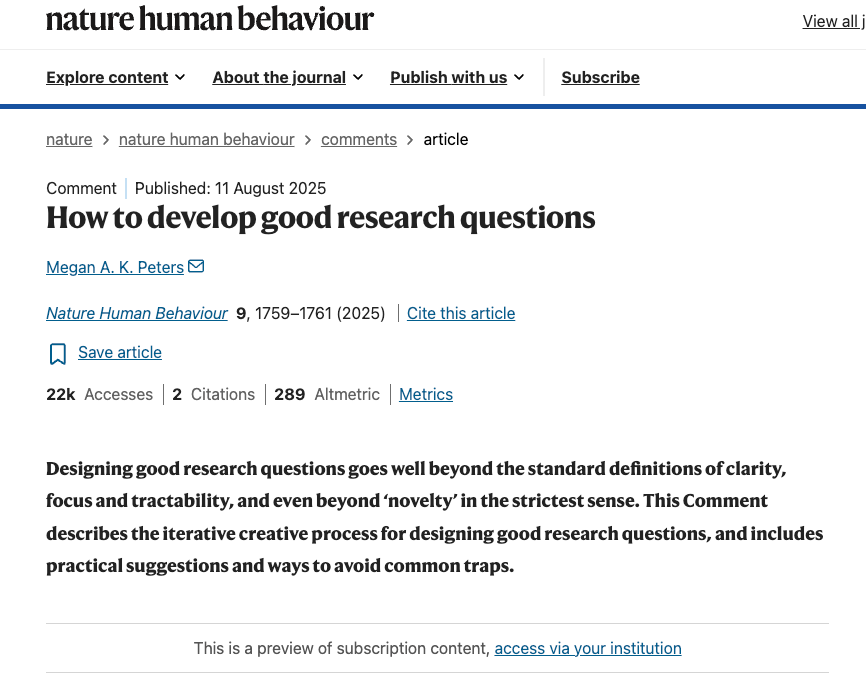
最近,重新读了《Nature Human Behaviour》的一篇评论文章,题目是《How to develop good research questions》。作者 Megan A. K. Peters 把研究问题的形成拆成了四个阶段:发散想法、建立文献联系、提炼核心问题,以及结合现实条件形成最终问题。
阶段 | 要解决的问题 | 最终产出 |
|---|---|---|
第一步:扫描论文 | 这个方向已经有哪些研究? | 相关论文库 |
第二步:形成综述 | 这个领域已经研究到了哪里? | 研究现状综述+文献矛盾地图 |
第三步:拆解与追问 | 哪个地方值得继续推进? | 有文献依据的候选问题 |
第四步:压力测试 | 哪个问题既有价值又做得完? | 最终问题+最小可行方案 |
01|第一步:尽可能把这个方向的相关论文搜出来
找选题的第一步,不应该是起题目,而是先看清楚这个方向已经研究了什么。
以前做这件事情非常耗时。我们需要先想关键词,再去不同数据库反复检索;中文论文和英文论文使用的表达不一样,还要不断切换同义词、缩写和相关概念。仅仅完成第一轮论文收集,经常花一整天时间。
现在有了Agent以后,这部分工作已经可以大幅提效。我们可以先给它一个大概方向,然后Agent可以自动扩展中英文关键词,跨数据库检索论文。以前需要一天完成的第一轮论文搜索,现在十分钟左右就可以先拿到一份相对完整的论文池。
Agent协助论文检索有两种有效的方式:
第一,如果你是Codex和Claude Code用户,你可以通过插件或者是Computer Use的功能,让Agent自动操作你的论文数据库,帮你搜索。
第二,如果你是YILA用户,操作就更简单了。YILA接入了Google Scholar,还有国内万方、知网的数据,对人文社科很友好。
例如,我会输入:
我目前关注“媒体融合传播效果评估”这个研究方向。帮搜索这个方向过去5年发表的论文。
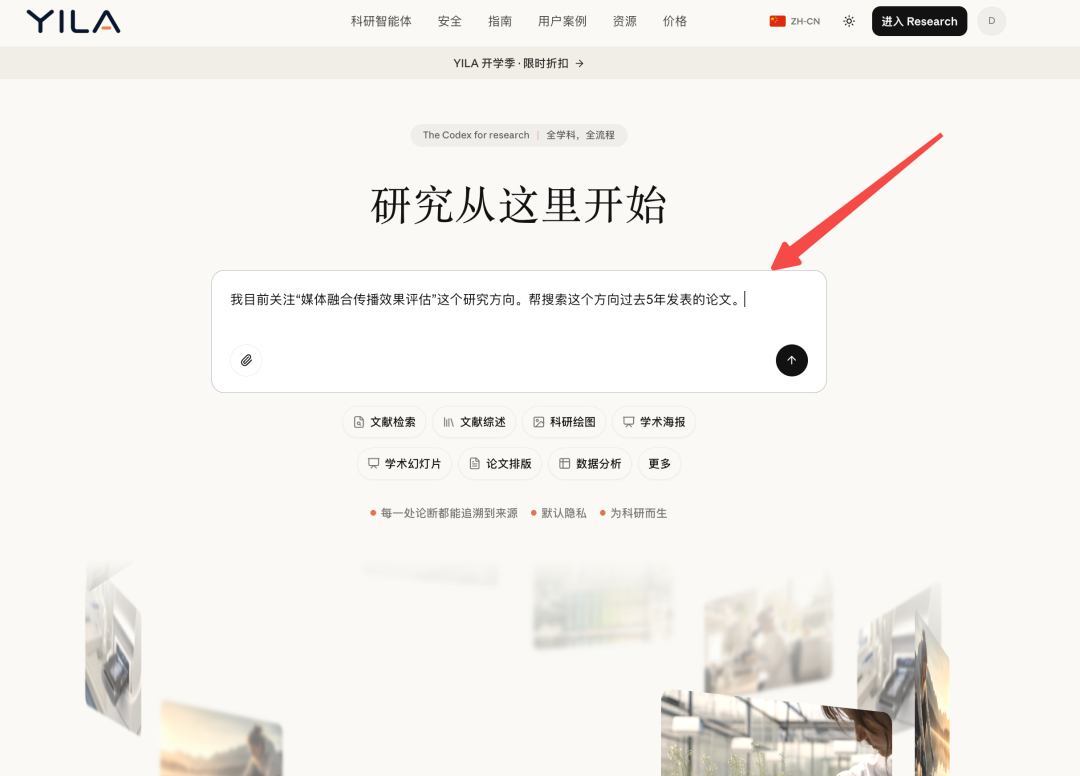
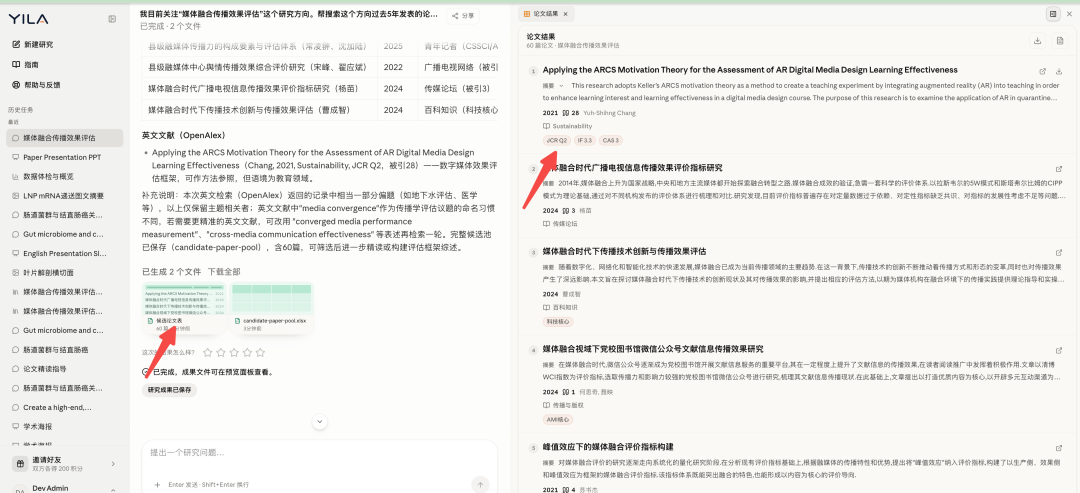
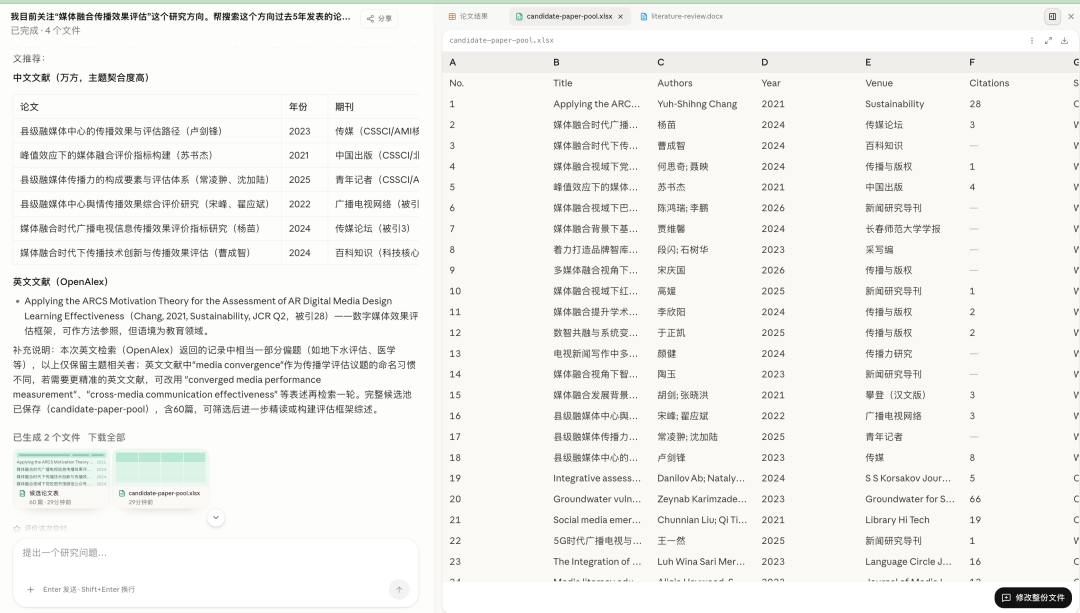
大概2分钟,Agent自动搜索到所有相关论文。并且还标注了期刊的级别。
如果你在检索论文的时候,还在反反复复切换关键词,请切换到Agent的模式。相信我,这个部分会会大大的节约时间。
第一步的结果不是论文题目,而是一份可以继续阅读和分析的相关论文库。已有的研究题目和问题,可以帮我们打开思路。
02|第二步:让Agent基于论文写一份研究现状综述
假设第一步收集到了100篇甚至200篇相关论文,新的问题很快就会出现:这么多论文,我应该从哪里开始看?它们分别研究了什么?哪些论文比较重要?我怎样从里面找到对选题真正有帮助的信息?
如果完全依靠人工阅读,我们可能需要用几周甚至更长时间,才能对一个方向形成基本认识。这个过程当然不能完全省略,但Agent可以先帮助我们完成第一轮阅读和整理,让我们更快看清这个领域的基本结构。
这也是AI在选题过程中第二个非常明显的提效空间:把一堆零散论文,整理成一份有证据的研究现状综述。
这里先要提一下,大家必须要避免的坑。
千万不要让AI直接写某个方向的综述。现在即使是Chatgpt、Gemini最好的模型,在学术领域依然有非常大的幻觉。
最安全的做法是,我们要让Agent基于已有论文去综述。
方法有两个:
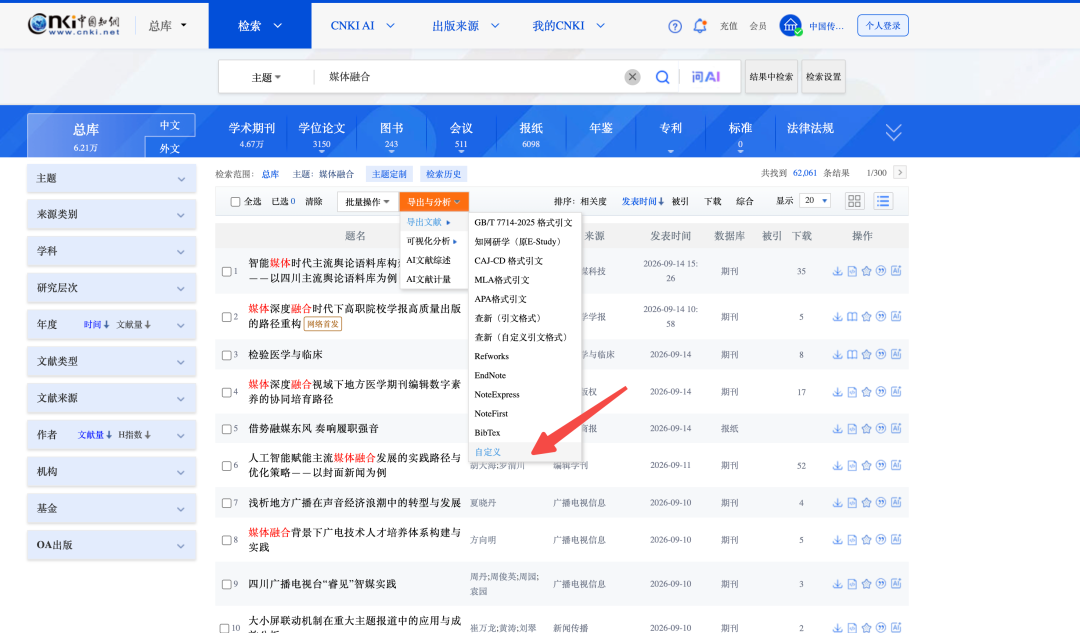
第一,我们可以在知网或者其他数据库里,直接导出你搜集到的论文。然后,投喂给你的Agent。例如,KIMI、豆老师等。(知网可以通过自定义的方式导出论文的摘要,比较适合投喂AI)
第二,可以直接在YILA的搜索结果里,连续追问。让他去生成综述。
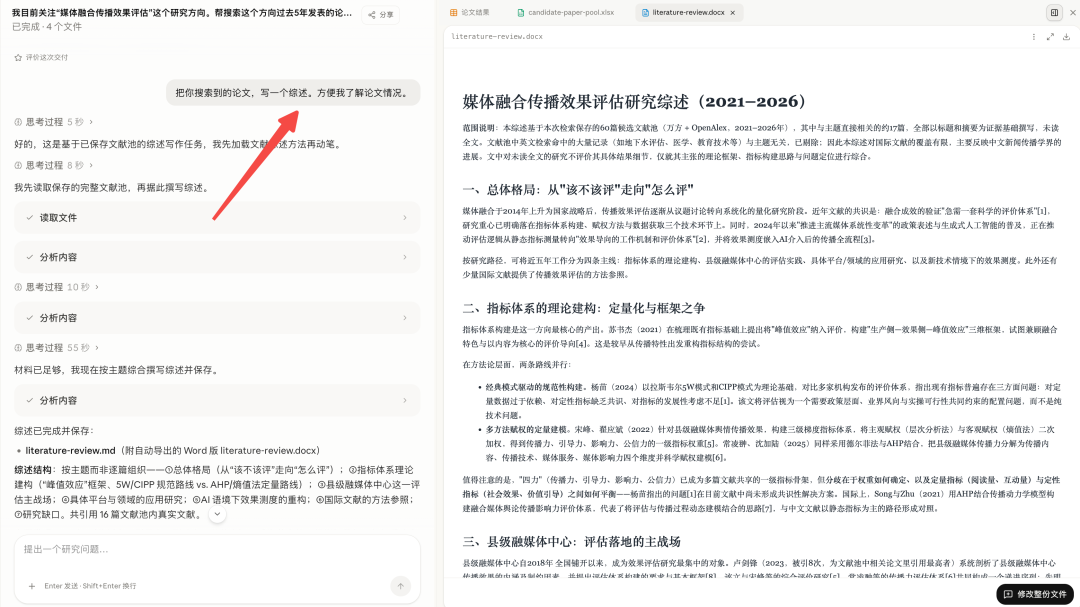
这一轮结束以后,我们应该得到两份结果:一份是帮助自己快速了解领域的研究现状综述,另一份是能够看到论文之间关系的证据表。
第二步的结果不是直接得到一个题目,而是对这个领域形成基本判断,知道共识在哪里、矛盾在哪里、还有什么没有解释清楚。
03|第三步:拆开核心论文,找到一个值得改变的地方
完成综述以后,我们已经知道别人做了什么。第三步真正要解决的问题是:我还可以做什么?
Nature论文作者给出的办法非常实用:回到与自己方向最接近的核心论文,重新读一遍,并且不断追问:“如果原来的研究换一种做法,结果会怎样?”
在前面两步的基础上,我们应该选定要精读的论文,去拆解。(这个时候,我们的范围可能已经从100篇,缩小到了10篇)
需要看清每篇论文研究了谁、怎样定义概念、使用什么数据、如何测量变量、采用什么方法、得出什么结论,以及还有哪些替代解释没有被排除。
然后再逐个改变其中的关键部分:如果换一种测量指标呢?如果同时使用行为数据和问卷数据呢?如果增加一个新的对照条件呢?如果换一个平台,结论还成立吗?如果两篇论文得出了相反结论,到底是理论不同,还是方法不同?
可以这样让Agent协助:
下面是研究现状综述,以及我筛选出的核心论文:【上传综述和核心论文】请先不要直接生成论文题目。请逐篇拆解这些论文的:1. 研究问题与理论视角;2. 核心概念及其定义;3. 研究对象与数据来源;4. 变量和测量方式;5. 研究方法与主要结论;6. 尚未排除的替代解释;7. 研究边界和局限。然后比较这些论文,重点寻找:- 相同问题是否使用了不同的测量方式;- 不同论文的结论是否存在冲突;- 冲突可能来自理论、样本、数据还是方法;- 哪些研究只使用了单一类型的数据;- 哪些共同假设还没有被直接检验;请基于以上证据形成3—5个可以继续推进的方向。每个方向都要说明对应论文、准备改变的部分、要检验的假设、能够解决的争议,以及它为什么不只是简单地换一个样本。
这样,候选问题就会从文献里慢慢长出来。
04|第四步:对候选问题进行收敛,留下一个真正做得完的问题
第三步可能会得到3—5个候选问题。第四步不是继续追求哪个题目听起来更高级,而是判断:哪一个问题既有研究价值,又是我真正能够完成的?
一个候选问题至少要接受几轮检查。它是否有明确的文献依据?与最接近的研究相比,真正的差异是什么?它是带来了新的理解,还是只换了一所学校、一座城市或者一批学生?需要的数据能不能拿到?现有方法能不能回答这个问题?还有哪些混杂因素和替代解释?按照现在的时间、经费和技术条件,能不能完成?
这一轮可以让AI扮演一位比较严格的开题评审专家,对候选问题进行压力测试:
下面是我目前形成的候选研究问题:【粘贴候选问题】我的实际条件是:- 可以接触的研究对象:【填写】- 可以获得的数据:【填写】- 已经掌握的研究方法:【填写】请扮演一位严格的开题评审专家,对每个候选问题进行压力测试,分别审查:1. 文献依据是否充分;2. 与最接近研究相比,真正的差异是什么;3. 是否只是简单更换了样本或情境;4. 是否能够获得所需数据;5. 研究方法能否真正回答问题;请为每个候选问题给出:支持它的核心文献、最大的研究价值、最明显的缺陷、最小可行版本和条件充足时的进阶版本。不要替我作出最终选择。
最终选择哪个问题,仍然不能完全交给AI。因为只有研究者自己知道,哪个现象真正让我感兴趣,哪个问题值得我投入时间,哪些数据是我能够获得的,以及我是否愿意为这个问题持续工作。
AI负责帮我们看清已有研究,研究者负责决定下一步往哪里走。
选题过程中,还要避开常见的坑
第一,不要因为已经读了很多文献,就舍不得换题。发现问题已经被回答,或者数据根本无法获得,该回头就回头。已经投入的时间,不是继续在错误方向上投入的理由。
第二,发现别人做过类似研究,不要立刻放弃。很多创新并不是“全世界从来没人做过”,而是在一个很小但关键的地方,比已有研究再往前走了一步。
第三,研究问题和论文选题应该建立在文献搜索的基础上。第一步永远是先检索到足够的文献。千万不要空对空的和AI聊选题。